



Pandas:数据分析绕不开的第一把刀
说实话,学 Python 做数据相关的事情,不管你最终走数据分析、数据科学还是后端 ETL,Pandas 都是你第一个要过的关。不是因为它最好,而是因为它太普遍了——StackOverflow 上 90% 的数据处理回答都是 Pandas 代码,ChatGPT 和 Claude 默认生成的也是 Pandas。你不学它,等于切断了自己最大的求助渠道。
但 Pandas 也不是没毛病。数据量一大就慢,API 设计有些地方让人想摔键盘,链式操作写多了自己都看不懂。这篇不是官方文档翻译,而是从"实际干活"的角度,帮你搞清楚 Pandas 到底怎么用、什么时候该用、什么时候该跑。
#先说结论
我在 JR Academy 教学生的时候发现,大家最常问的就是"我到底该不该学 Pandas"——答案取决于你的场景,所以我直接给结论:
- 数据量 < 1GB,用 Pandas,没什么好犹豫的
- 数据量 1-10GB,先试 Pandas,不行换 Polars 或 DuckDB
- 数据量 > 10GB,别挣扎了,上 PySpark 或 DuckDB
- 如果你只需要跑几条 SQL 查询,Pandas 都不需要,直接写 SQL
- 如果你的工作是 Excel 里点来点去,Pandas 能把你的效率提升 10 倍,但前提是你愿意花两周学基础
Pandas 的核心价值不是"快",而是"什么都能干"——读 CSV、连数据库、清洗脏数据、做透视表、画图、导出 Excel,一条龙。这个"瑞士军刀"属性,短期内没有替代品。
#这几个概念你得先搞明白
#DataFrame:一张 Excel 表
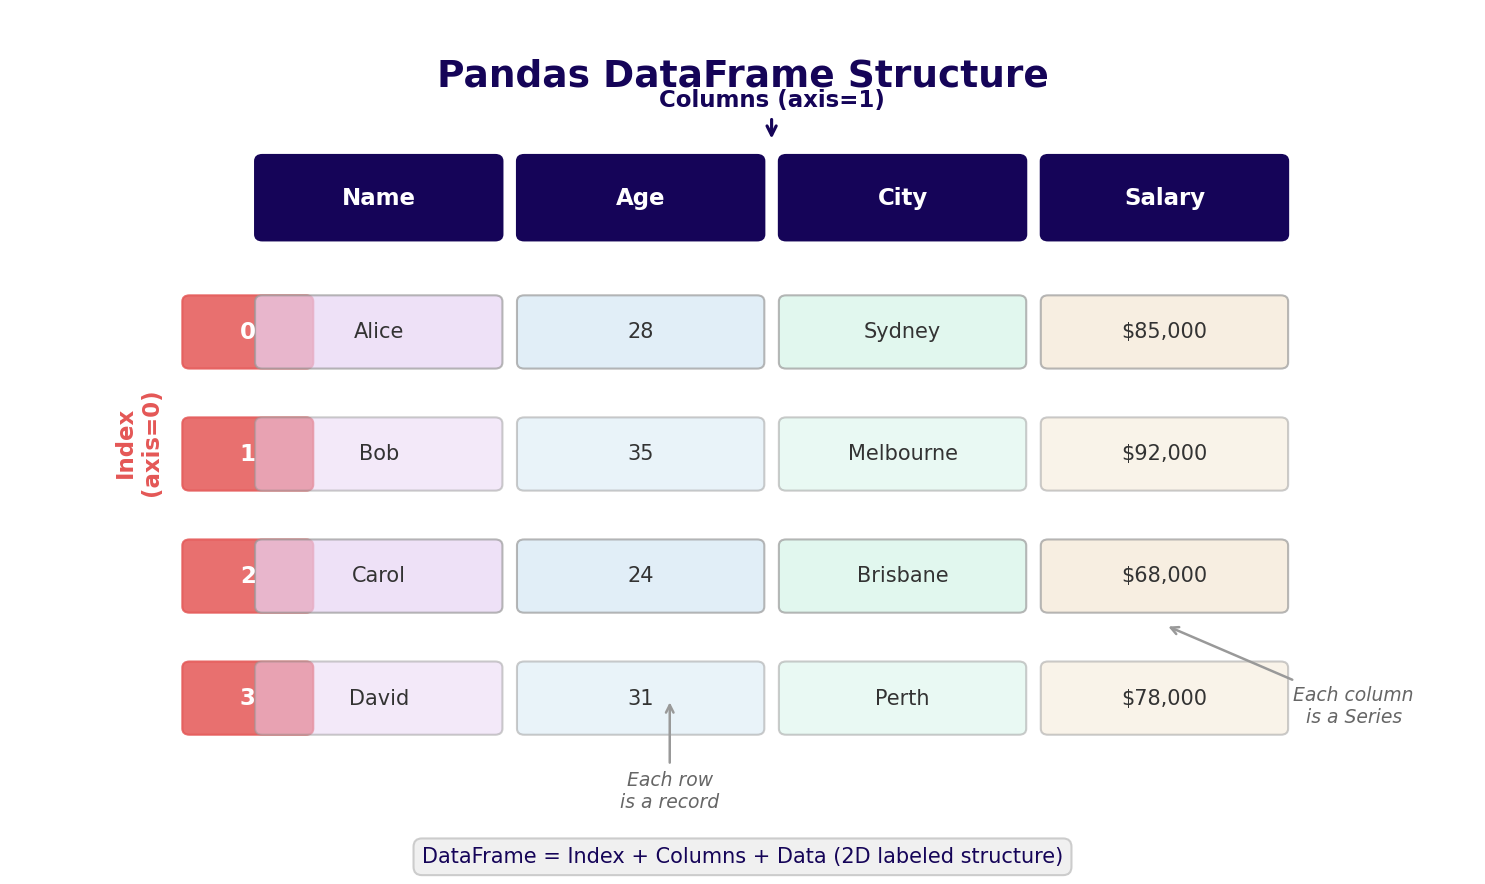
DataFrame 就是一张表,有行有列。你可以把它想象成一张 Excel 工作表,但它活在 Python 里,能用代码操作。
pythonimport pandas as pd df = pd.read_csv('sales.csv') df.head() # 看前 5 行,相当于打开 Excel 先扫一眼
#Series:Excel 里的一列
Series 就是 DataFrame 里面单独拿出来的一列。比如你有一张销售表,把"金额"这列单独拿出来,就是一个 Series。
pythonrevenue = df['revenue'] # 拿出 revenue 这列 revenue.mean() # 算平均值
#Index:每行的门牌号
Index 就是每一行的标签。默认是 0, 1, 2, 3... 但你也可以把某列设成 Index,比如用日期做行标签,方便按时间切片。
怎么理解呢?你住的小区,每栋楼有门牌号,靠门牌号才能找到具体是哪家。Index 在 DataFrame 里就是这个作用。
#GroupBy:分组统计的核心
GroupBy 就是 SQL 里的 GROUP BY。比如你有一张订单表,想按城市算总销售额:
pythondf.groupby('city')['revenue'].sum()
这个其实不难理解——班主任期末把学生按性别分两拨,分别算平均分。先分组,再计算,GroupBy 干的就是这事。
#merge / join:把两张表拼起来
这就是 SQL 的 JOIN。比如你有一张订单表和一张客户表,想把客户名字加到订单表里:
pythonresult = pd.merge(orders, customers, on='customer_id', how='left')
想象你手里有一本通讯录、一本快递单,快递单上只有名字没有电话。你对着通讯录把电话号码一个个抄到快递单上——merge 做的就是这个动作,只不过它一秒钟能抄几百万行。
#真实使用场景
讲完概念来看看实际干活的时候 Pandas 都在哪些地方出场。下面几个场景我自己或者身边同事都经历过,不是编的。
#清洗脏数据——Pandas 吃饭的活
这是 Pandas 最高频的用途,没有之一。说个真事,我之前帮一个客户处理他们从 CRM 导出的客户数据,里面的电话号码格式五花八门——有带空格的、带括号的、带加号的、还有填了"N/A"的。当时看到那个 CSV 我人都麻了。
pythondf = pd.read_csv('customers.csv') # 先看看有多少空值 df.isnull().sum() # 电话号码:去空格、去括号,空的填 NaN df['phone'] = df['phone'].str.replace(r'[\s\(\)\-]', '', regex=True) df['phone'] = df['phone'].replace(['N/A', 'NA', ''], pd.NA) # 去重:同一个邮箱只保留最新的一条 df = df.sort_values('created_at', ascending=False) df = df.drop_duplicates(subset='email', keep='first')
这种活你用 Excel 也能干,但如果数据有 10 万行,Excel 卡死你,Pandas 几秒搞定。
#自动生成月度报表
我见过太多公司的报表流程是这样的:从数据库导 CSV → 打开 Excel → 手动做透视表 → 截图发群。每个月重复一次,每次花半天。老实说,这种重复劳动看着就心疼。
用 Pandas 写成脚本,一次写好,每月跑一次就行:
pythondf = pd.read_sql('SELECT * FROM orders WHERE month = %s', conn, params=[current_month]) # 按产品分类汇总 summary = df.groupby('product_category').agg( total_revenue=('revenue', 'sum'), order_count=('order_id', 'count'), avg_order_value=('revenue', 'mean') ).round(2) # 导出 Excel,自带格式 summary.to_excel('monthly_report.xlsx', sheet_name='Summary')
#给机器学习做特征工程
做 ML 的同学应该深有体会——80% 的时间其实都在处理数据,真正训练模型的代码可能就几行。Pandas 在数据准备这个环节几乎不可替代:
python# 时间特征 df['order_hour'] = pd.to_datetime(df['order_time']).dt.hour df['is_weekend'] = pd.to_datetime(df['order_time']).dt.dayofweek >= 5 # 编码分类变量 df = pd.get_dummies(df, columns=['city', 'product_type']) # 处理缺失值 df['age'].fillna(df['age'].median(), inplace=True)
#Pandas 最容易翻车的地方
这部分是实战里攒下来的教训,每条都有人踩过。
| 问题 | 症状 | 原因 | 最省力的修法 |
|---|---|---|---|
| SettingWithCopyWarning | 一堆黄色警告 | 对切片后的 DataFrame 赋值 | 用 .loc[] 或 .copy() |
| 内存爆了 | 进程被 kill | 数据太大,Pandas 全部加载到内存 | 用 dtype 指定类型,或分块读取 chunksize |
| merge 之后行数暴增 | 合并后行数比原来多好几倍 | 有重复 key,变成了笛卡尔积 | 合并前先 drop_duplicates |
| 日期解析出错 | 时间列变成字符串 | CSV 里日期格式不统一 | 读取时指定 parse_dates + dayfirst |
| apply 太慢 | 简单操作跑了几分钟 | 用了 apply 而不是向量化操作 | 改用内置方法或 np.where |
| inplace 陷阱 | 改了但好像没改 | inplace=True 和链式操作冲突 | 别用 inplace,直接赋值 |
关于 SettingWithCopyWarning 多说一句:这是新手最困惑的警告。简单规则——只要你是从 DataFrame 切出来的子集,想修改它之前先 .copy() 一下,问题就没了。
python# ❌ 会报警告 subset = df[df['age'] > 30] subset['tag'] = 'senior' # ✅ 安全写法 subset = df[df['age'] > 30].copy() subset['tag'] = 'senior'
#AI 时代的 Pandas
说实话,AI 让 Pandas 变得更好用了。以前你得记住一堆 API,现在直接描述需求就行。
#用 ChatGPT / Claude 写 Pandas 代码
最高效的姿势:把你的数据前几行贴给 AI,然后用自然语言描述你要干什么。
我的数据长这样:
name, city, revenue, date
张三, 上海, 5000, 2024-01-15
李四, 北京, 3000, 2024-01-16
...

帮我按城市算月度总收入,并画一个柱状图。
AI 生成的 Pandas 代码准确率非常高,因为 Pandas 在训练数据里占比极大。
#什么时候 AI 生成的代码要小心
- 大数据量的性能问题:AI 可能给你写
apply而不是向量化操作,小数据没区别,大数据慢 100 倍 - merge 的 how 参数:AI 有时候默认用
inner,你可能需要left,一字之差结果完全不同 - 时区处理:AI 经常忽略时区,如果你的数据涉及多时区,自己检查一遍
#在 Jupyter 里配合 AI
在 Jupyter Notebook 里用 Pandas + AI 是目前最顺滑的数据分析流程。写一段,跑一段,看结果,再让 AI 帮你改。这个反馈循环非常快。
#版本与生态注意事项
#Pandas 2.x 的变化
Pandas 2.0(2023 年发布)引入了 Apache Arrow 作为后端,这意味着:
- 内存占用更小:字符串列从 Python 对象变成 Arrow 字符串,内存省一半
- 速度更快:某些操作快了 2-5 倍
- nullable 类型更统一:不再用
NaN和None混着来
升级建议:新项目直接用 2.x,老项目如果没遇到性能瓶颈,先别急着升,API 有些小变化可能影响你的代码。
#和其他工具的关系
| 工具 | 和 Pandas 的关系 |
|---|---|
| NumPy | Pandas 的底层,数组计算引擎 |
| Matplotlib / Seaborn | Pandas 内置 .plot() 就是调它们 |
| Scikit-learn | 接受 DataFrame 作为输入 |
| Polars | Pandas 的高性能替代,API 不同但思路类似 |
| DuckDB | 可以直接对 DataFrame 跑 SQL |
| Jupyter | Pandas 最常见的运行环境 |
| SQLAlchemy | Pandas read_sql 背后的数据库连接层 |
#安装
bashpip install pandas # 推荐:带性能优化的完整安装 pip install "pandas[performance]" # 如果要读写 Excel pip install openpyxl
#适不适合你:快速自检
在学 Pandas 之前,先过一遍这个清单:
- 你是否经常处理 CSV、Excel 或数据库里的表格数据
- 你是否厌倦了在 Excel 里重复操作
- 你会基础 Python(变量、循环、函数)
- 你处理的数据量在几百 MB 以内
- 你需要做数据清洗、统计汇总或可视化
如果 3 个以上打勾了,Pandas 就是你下一步该学的。
如果你的数据全在数据库里,而且只需要简单查询和聚合,可能直接写 SQL 更高效。Pandas 的优势在"SQL 做不了的事"——复杂清洗、多源数据合并、特征工程、自定义计算。
#什么时候千万别用 Pandas
这个不是唱反调,而是为了帮你省时间:
- 实时数据处理:Pandas 是批处理工具,不适合流式数据,考虑 Kafka + Flink
- 超大规模数据:超过内存的数据,Pandas 直接 OOM,换 Spark 或 Dask
- 生产环境的 API 服务:别在 Web 服务里 import pandas 做计算,启动慢、内存大,用 SQL 或专用服务
- 简单的文件读写:只是读个 JSON 或 CSV 取一两个字段,
csv标准库就够了,不用搬出 Pandas
#相关资源
- Polars 指南 — Pandas 的高性能替代方案
- DuckDB 指南 — 对 DataFrame 直接跑 SQL
- Jupyter 指南 — Pandas 最佳搭档
#官方资源
- Pandas 官网:https://pandas.pydata.org↗
- Pandas 文档:https://pandas.pydata.org/docs/↗
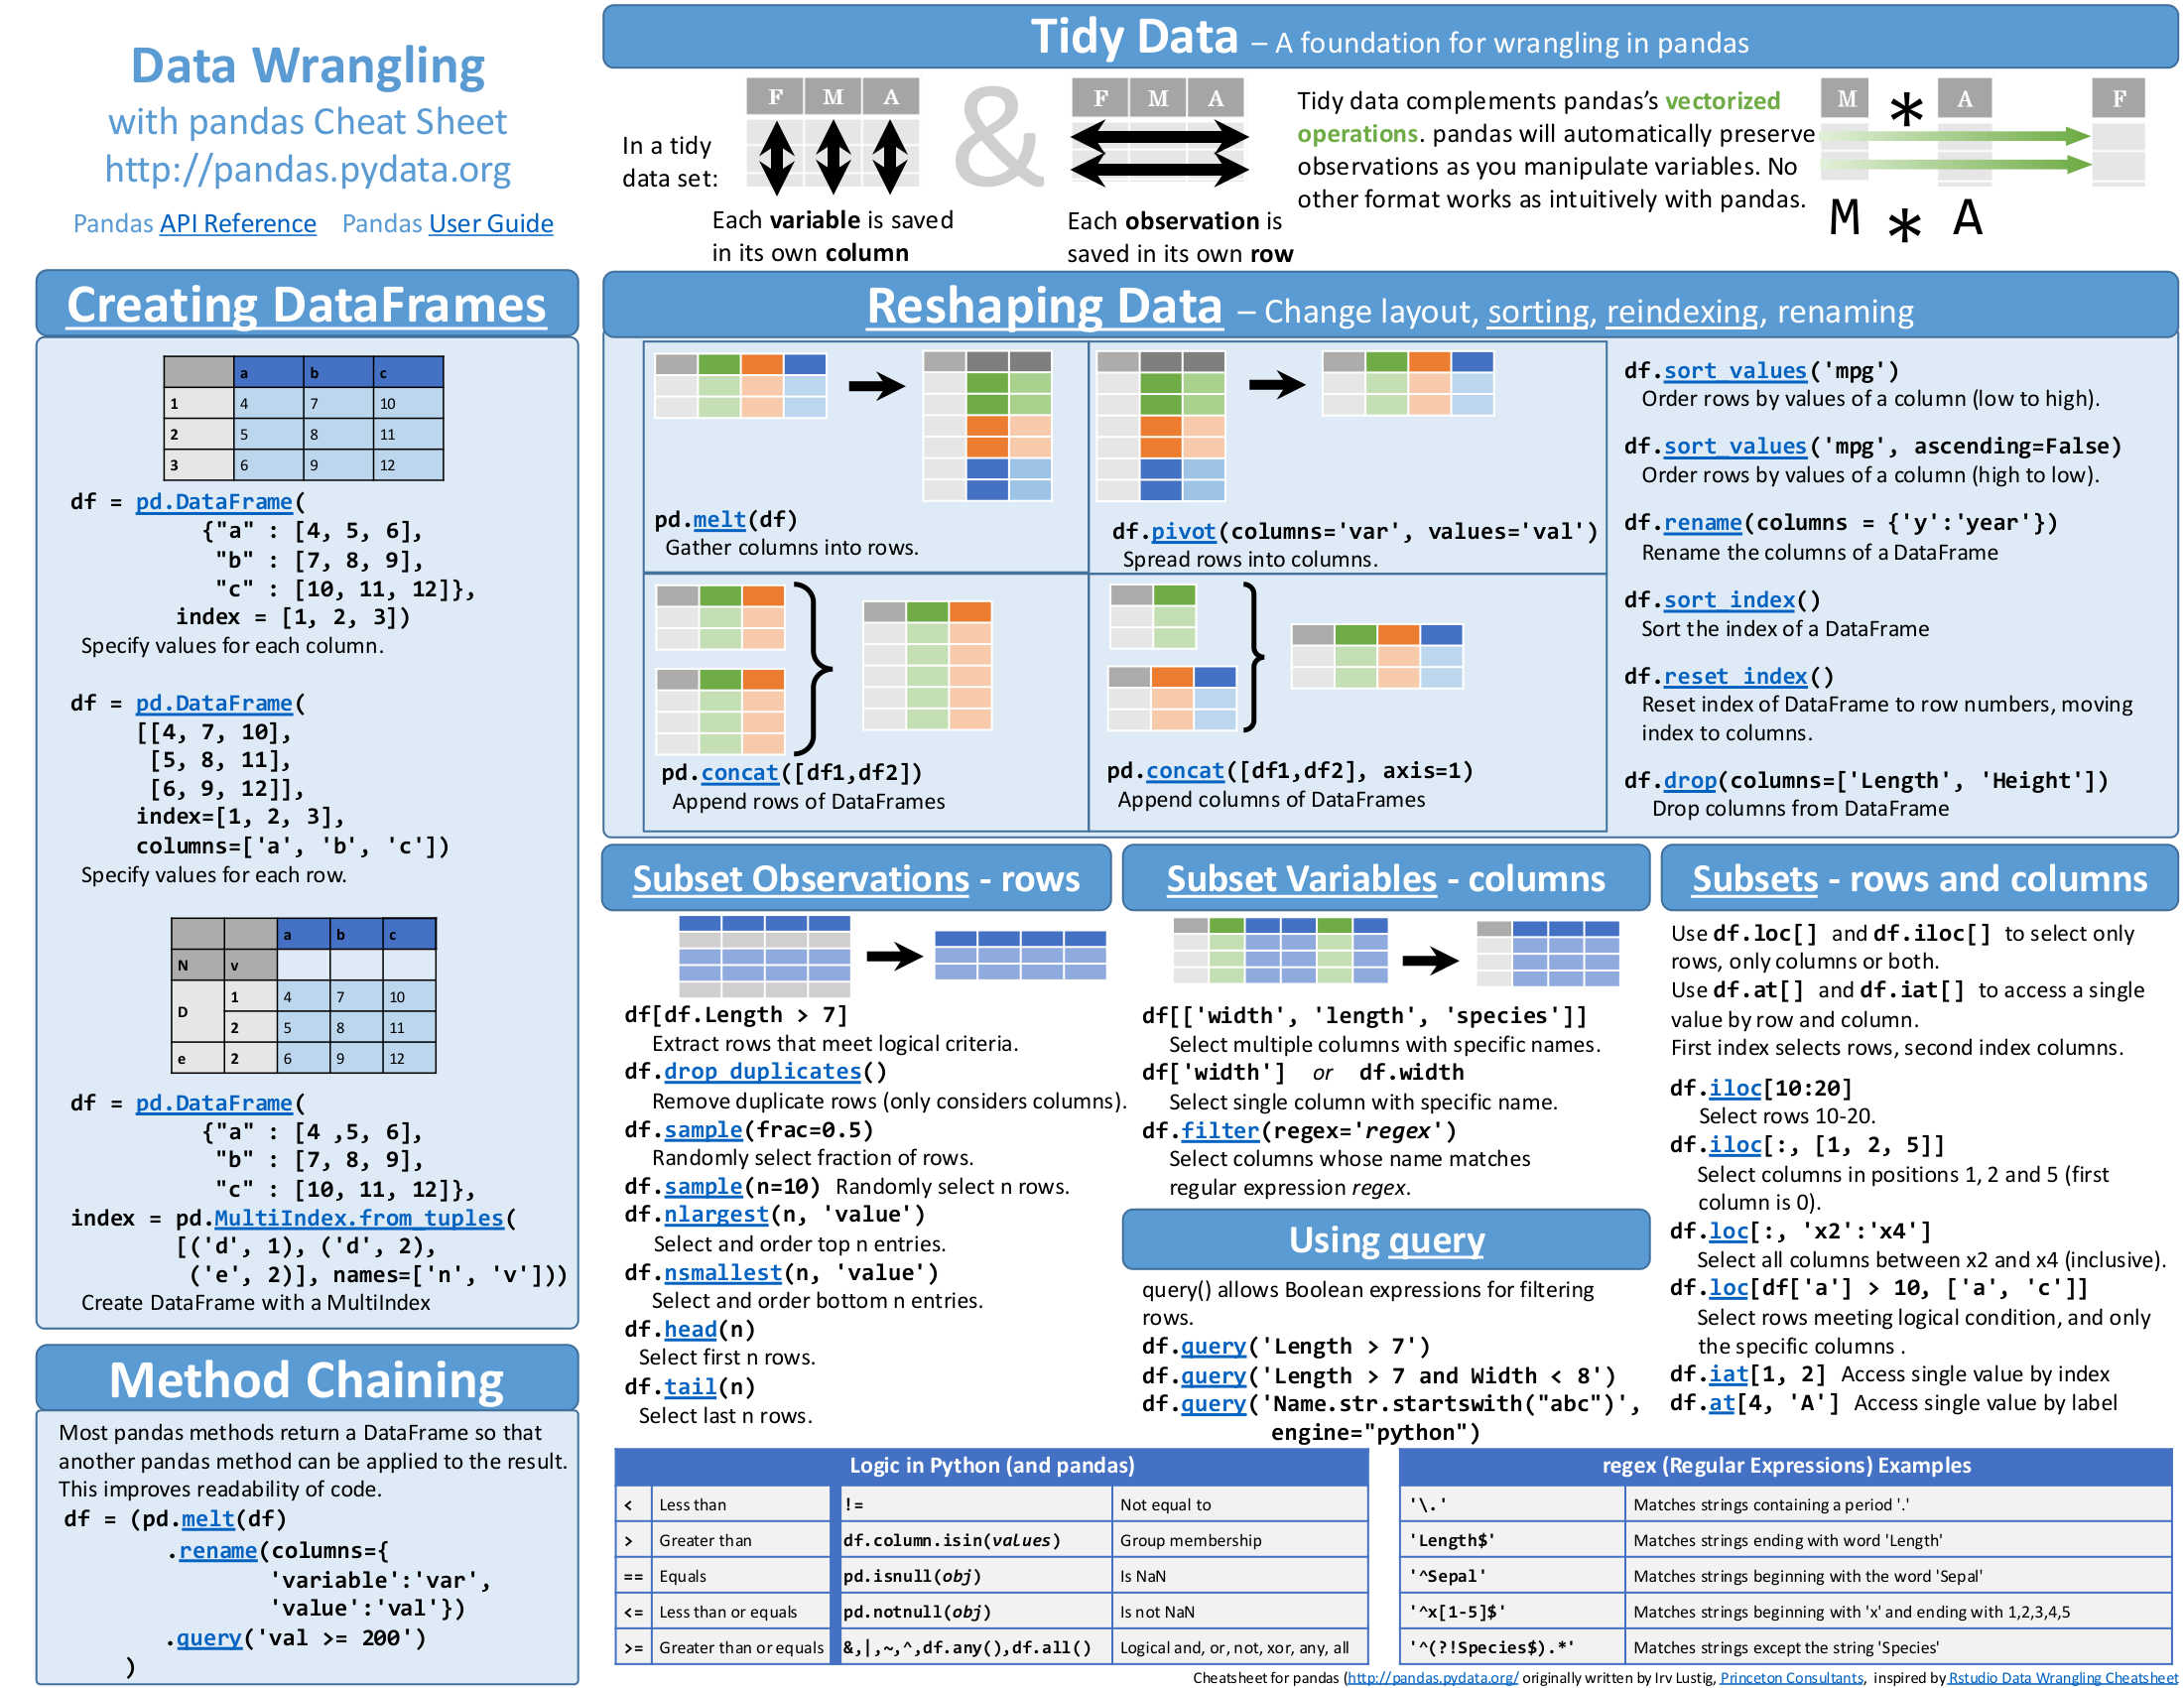
- Pandas Cheat Sheet:https://pandas.pydata.org/Pandas_Cheat_Sheet.pdf↗