匠人学院 JR Academy
  • Position

    我现在在哪,该往哪走?

    几道题看你现在的岗位受 AI 影响多大、机会在哪。免费,不用注册。

    免费看看我现在在哪

    AI 对职业的影响

    我的工作会被 AI 替代吗常见职业的 AI 影响与转型方向AI 时代的新岗位做什么、要求什么、怎么转过去AI 影响自测几道题看你所在岗位的风险和机会

    测一测

    能力测评AI Engineer 面试准备度自测职业性格测试找到和你性格匹配的方向职业规划回答几个问题,看可能适合的职业回国求职评估按学校、专业、毕业时间看回国机会
  • Skill

    不知道该学什么 AI?

    先按方向免费学,每个方向从入门讲到动手做;想系统学再看训练营和导师。

    按方向免费开始学

    按方向免费学

    Vibe Coding用 AI 写代码,零基础可学AI 办公提效文档、表格、汇报用 AI 省时间Prompt 大师把需求说清楚的写法AI EngineerRAG、Agent、MCP 工程实践AI 数据分析用 AI 做查询、清洗和报表全部学习方向 →

    训练营与课程

    全部训练营按职业方向、难度、形式筛选AI Engineer Bootcamp从 LLM 应用到 Agent 的工程训练营人人都能学的 AI Coding非技术背景的 AI 编程实战AI 工作流提效营在职人士的 AI 工作流导师团队一线工程师与行业导师全部课程 →

    动手练与资料

    互动 LabPrompt、前端、Python、AWS 在线练学习路线图一张图看清该按什么顺序学Cheat Sheets语言与工具速查表Wiki 知识库AI 工具与概念讲解视频讲座、公开课、学员分享免费资源 →
  • Evidence

    拿什么让雇主相信你?

    证书、项目、团队实战、比赛作品,最后整理成一份作品档案。

    了解作品档案

    考证

    考证匠 · 全部认证AWS、Azure、GCP、Claude 等备考与模考AWS SAA-C03云架构师入门认证Azure AI-102微软 AI 工程师认证Claude 认证Anthropic Claude 系列认证模拟考试按真实考试界面限时练全部认证 →

    项目与团队实战

    P3 团队实战和真人协作做项目,模拟实习式的团队流程P3 项目经历P3 项目能写进简历的部分Demo Day项目成果展示P3 证书完成项目后的证明P3 全部 →

    比赛与作品

    黑客松限时做出一个作品提交作品把你的项目放进作品展示CareerOS 作品档案在桌面版做任务,提交的结果整理成作品
    考证匠浏览器插件 + App + 小程序截屏分析考题,随时刷题了解考证匠
  • Connect

    怎么把自己推出去?

    简历、面试、内推、导师。先看你和目标岗位差多少,再决定从哪补。

    用求职匠开始

    简历与机会

    毕业生求职澳洲、中国、马来西亚、新加坡、美国、英国求职准备求职匠AI 求职工作台:改简历、找岗位、投递AI 简历对照 JD 改写简历内推机会学员和导师分享的内推岗位机会实习、项目和合作机会Offer 榜学员拿到的 Offer

    面试

    AI 模拟面试文字或语音练一次,看差在哪面试中心按公司和岗位找题面经真实面试经历System Design 手册系统设计面试准备面试全部 →

    导师

    1v1 导师按小时约 AI、求职、技术导师拼团私教几个人一起上,每人更便宜职业辅导服务简历、面试、方向的辅导套餐成为导师加入匠人导师团队
    求职匠桌面版一个工作台管完整求职在 macOS/Windows 整理真实经历,按岗位完善简历版本。了解求职匠
  • Community

    去哪认识同路的人?

    讲座、公开课、Workshop、黑客松,线上线下都有。

    看近期活动

    活动类型

    讲座行业嘉宾分享公开课免费试听课程内容Workshop动手做一个小作品黑客松组队限时开发新生节开学季的校园活动

    城市

    悉尼悉尼的线下活动墨尔本墨尔本的线下活动布里斯班布里斯班的线下活动线上在哪都能参加全部活动 →

    社群

    职业社区求职者互助学习小组找人一起学Discord在线交流群
企业会员下载 CareerOS
0
匠人学院 JR Academy学AI来匠人

Follow Us

linkedinfacebooktwitterinstagramweiboyoutubebilibilitiktokxigua

We Accept

/image/layout/pay-paypal.png/image/layout/pay-visa.png/image/layout/pay-master-card.png/image/layout/pay-airwallex.png/image/layout/pay-alipay.png
EN
产品

CareerOS 与工具

  • CareerOS
  • 考证匠
  • 求职匠
  • 求职匠网页版
  • 求职匠分析报告
  • 求职匠桌面版下载
  • 我的求职报告
  • 购买报告次数
  • 求职匠账单
  • AI 工具箱
  • AI Skill 商城

会员与课程

  • 会员
  • AI 会员
  • AI Engineer VIP
  • 训练营
  • Training Camp
  • 看板学习
  • AI Builder 课程
  • MCP 课程
  • NotebookLM Workshop
  • Business Analyst 课程
  • Web全栈班
  • DevOps项目班
  • 数据工程全栈班
  • 数据分析项目班
  • 编程入门班
  • 算法集训营

求职服务

  • 毕业生求职
  • 澳洲毕业生求职
  • 中国毕业生求职
  • 马来西亚毕业生求职
  • 新加坡毕业生求职
  • 美国毕业生求职
  • 英国毕业生求职
  • 1v1 辅导
  • 职业辅导
  • BA和产品经理实习
  • 数据科学实习
  • 数据分析实习
  • Marketing实习
  • 简历修改
  • 面试指导
  • 岗位代投
  • 职位监控
  • LinkedIn代运营
  • LinkedIn人脉代加
内容库

学习方向

  • 全部学习方向
  • AI Engineer
  • Context Engineering
  • Vibe Coding
  • Prompt Master
  • AI Builder
  • AI 产品经理
  • Python 入门
  • AI 办公提效
  • AI 数据分析
  • AI 财务
  • AI 内容创作
  • AI 视觉创作
  • 前端开发
  • Hermes Agent
  • OpenClaw 本地智能体

互动 Lab

  • Prompt Lab
  • Frontend Lab
  • JavaScript Lab
  • Python Lab
  • AWS Lab
  • Azure Lab
  • LLM Lab
  • Git Lab

资料与指南

  • Wiki 知识库
  • 学习 Wiki
  • Cheat Sheets
  • 学习路线图
  • AI 路线图
  • 视频
  • 博客
  • 面试手册
  • 模拟考试
  • 免费资源

城市

  • 悉尼
  • 墨尔本
  • 布里斯班
  • 阿德莱德
  • 新加坡
  • 吉隆坡
  • 伦敦
  • 纽约
  • 旧金山
  • 洛杉矶
  • 西雅图
  • 多伦多
  • 温哥华

移民

  • 澳洲移民
  • 技术移民189/190/491
  • 雇主担保482/186/494
  • 投资移民188/888
  • 英国移民
  • 美国移民
  • 加拿大移民
  • 新加坡移民
  • 马来西亚移民
企业

企业服务

  • AI for Business
  • 企业门户登录
  • 企业培训
  • 实习合作
  • 招聘合作
  • Enterprise (EN)

Metatree AI Lab

  • Metatree AI Lab
  • AI 解决方案
  • 数字员工
  • 案例
  • Metatree AI Lab(英文)
  • AI Services(英文)
  • Digital Employee(英文)
  • Work(英文)

青少年 AI 教育

  • Airbotix 少儿 AI 编程
  • 澳洲家长实用资料库
  • NAPLAN 成绩单怎么看
  • My School 学校数据指南
  • 悉尼私校学费 2026
  • 少儿编程课程与训练营
关于

公司

  • 关于我们
  • 匠人导师
  • 成为导师
  • 新闻资讯
  • 元宇宙课堂
  • 匠人工作
  • 匠人商店J3.Club
  • 联系我们

帮助与条款

  • 常见问题
  • 服务条款
  • 隐私政策
  • 取消与退款政策
  • 网站地图

友情链接

  • CS Browser

联系

  • hello@jiangren.com.au
  • 0421-672-555

地址

Level 10b, 144 Edward Street, Brisbane CBD (Headquarter)
Level 2, 171 La Trobe St, Melbourne VIC 3000
四川省成都市武侯区桂溪街道天府大道中段500号D5东方希望天祥广场B座45A13号
Business Hub, 155 Waymouth St, Adelaide SA 5000

Disclaimer

footer-disclaimerfooter-disclaimer

JR Academy acknowledges Traditional Owners of Country throughout Australia and recognises the continuing connection to lands, waters and communities. We pay our respect to Aboriginal and Torres Strait Islander cultures; and to Elders past and present. Aboriginal and Torres Strait Islander peoples should be aware that this website may contain images or names of people who have since passed away.

匠人学院网站上的所有内容,包括课程材料、徽标和匠人学院网站上提供的信息,均受澳大利亚政府知识产权法的保护。严禁未经授权使用、销售、分发、复制或修改。违规行为可能会导致法律诉讼。通过访问我们的网站,您同意尊重我们的知识产权。JR Academy Pty Ltd 保留所有权利,包括专利、商标和版权。任何侵权行为都将受到法律追究。查看用户协议

© 2017-2026 JR Academy Pty Ltd. All rights reserved.

ABN 26621887572

首页学习AI课程考证
跳至正文
学习指南
DuckDB 分析数据库指南

DuckDB 是嵌入式分析数据库,支持直接查询 CSV/Parquet 文件,无需导入。

1 个章节·1 篇指南·按章节权限阅读
开始阅读 ↓
官方网站 ↗官方文档 ↗
DuckDB 简介

DuckDB 分析数据库指南

快速入门

  • DuckDB 简介

相关链接

  • ↗官方网站
  • ↗官方文档
  1. 首页
  2. 学技能
  3. Wiki 知识库
  4. DuckDB 分析数据库指南
本页内容
先说结论:DuckDB 适合谁DuckDB 的核心能力1. 直接用 SQL 查询文件——这个功能真的会上瘾2. 和 Python 无缝集成3. 列式存储:为什么分析场景下它碾压 SQLite4. 向量化执行真实使用场景场景一:本地大文件分析场景二:ETL 原型开发场景三:Notebook 里的数据探索DuckDB vs Pandas vs SQLite 详细对比最容易翻车的地方1. DuckDB 不适合做应用数据库2. 内存还是有上限的3. 持久化数据库文件的坑——我自己也中过招4. 版本兼容性5. 跨进程并发写入安装与快速上手安装30 秒快速体验命令行使用进阶技巧用 DuckDB 替代 `pd.read_csv()`查询远程 S3 文件多文件批量查询相关资源

DuckDB 指南

你有没有遇到过这种情况:一个 2GB 的 CSV 文件,用 Pandas 读了 40 秒,内存直接飙到 8GB,风扇开始狂转。换成 DuckDB,3 秒搞定,内存几乎没动。

这不是夸张,这是 DuckDB 最直观的卖点——在你自己的电脑上,用 SQL 跑大数据分析,不用装任何数据库服务。

如果要用一句话概括 DuckDB,它就是数据分析界的 SQLite,一个随身携带的分析引擎。SQLite 解决了"我想在本地存点数据但不想装 MySQL"的问题,DuckDB 解决的是"我想在本地分析大数据但不想装 Spark"的问题。
DuckDB 命令行数据处理
DuckDB 命令行数据处理


#先说结论:DuckDB 适合谁

别浪费时间,先看看你是不是目标用户:

  • 数据分析师:天天跟 CSV、Parquet 打交道,Pandas 写到怀疑人生的那种
  • 数据工程师:需要在本地快速验证 ETL pipeline,不想每次都连远程数据库
  • 后端开发者:想在应用里嵌入轻量分析能力,又不想维护一个独立的数据库服务
  • 机器学习工程师:特征工程阶段需要对大量数据做聚合、筛选、join
  • 学生和自学者:想学 SQL 但不想折腾 PostgreSQL 安装配置

如果你的日常工作是处理几百 MB 到几十 GB 的数据,而且经常在本地做分析,DuckDB 基本上是目前最好的选择。


#DuckDB 的核心能力

#1. 直接用 SQL 查询文件——这个功能真的会上瘾

我第一次用 DuckDB 替代 pd.read_csv 的时候,感觉就像从自行车换成了电动车——不是快一点点,是质的飞跃。当时有个 3GB 的用户日志,Pandas 读了快一分钟,DuckDB 两三秒就出结果了。从那以后我就再也回不去了。

不用先把数据导入数据库,直接对文件写 SQL:

sql
-- 查询本地 CSV 文件 SELECT city, COUNT(*) as order_count, AVG(amount) as avg_amount FROM 'orders_2024.csv' WHERE status = 'completed' GROUP BY city ORDER BY order_count DESC LIMIT 10; -- 查询 Parquet 文件(列式存储,速度更快) SELECT * FROM 'user_events/*.parquet' WHERE event_date >= '2024-01-01'; -- 甚至可以直接查远程文件 SELECT * FROM 'https://example.com/data/sales.csv' LIMIT 100;

FROM 后面直接写文件路径,通配符、远程 URL、CSV / Parquet / JSON 都支持。头几次用的时候总觉得"不对吧,这也行?",但它就是行。

#2. 和 Python 无缝集成

说实话,我之前对"在 Python 里写 SQL"这件事是有偏见的——总觉得两种语言混着写很别扭。直到用了 DuckDB,才发现它做到了一种很舒服的共存:SQL 负责查询和聚合,Python 负责后续处理和画图,各干各的。

python
import duckdb import pandas as pd # 直接查询 Pandas DataFrame,不需要导入 df = pd.read_csv('users.csv') result = duckdb.sql("SELECT age, COUNT(*) FROM df WHERE country = 'AU' GROUP BY age") # 查询结果直接转回 DataFrame result_df = result.df() # 也可以转成 Polars DataFrame result_pl = result.pl() # 或者直接转成 Python 列表 rows = result.fetchall()

注意这里的关键:DuckDB 可以直接查询 Python 变量名。你定义了一个叫 df 的 DataFrame,SQL 里直接写 FROM df 就能用。不需要注册表、不需要创建连接,开箱即用。第一次见到这个设计的时候我愣了几秒——"等等,它怎么知道 df 是什么?"答案是 DuckDB 会自动扫描当前 Python 作用域里的变量。有点黑魔法,但确实好使。

#3. 列式存储:为什么分析场景下它碾压 SQLite

这部分稍微偏原理,不感兴趣可以跳过,但我觉得理解了之后会更有信心在生产环境使用它。

传统数据库(包括 SQLite)按行存储。跑 SELECT AVG(salary) FROM employees 时,它把每一行的所有列都读出来,哪怕你只关心 salary。DuckDB 是列式存储,同样的查询只读 salary 那一列,I/O 差了一个数量级。实测下来分析场景比 SQLite 快 10-100 倍不夸张。

打个比方:行式存储像翻一整本书找章节标题,列式存储像直接看目录。

#4. 向量化执行

DuckDB 处理数据不是一行一行来的,而是一批一批(通常 2048 行一批),能更好地利用 CPU 缓存和 SIMD 指令。具体细节不展开了,你只需要知道:这是它在分析查询上跑得快的另一个核心原因。
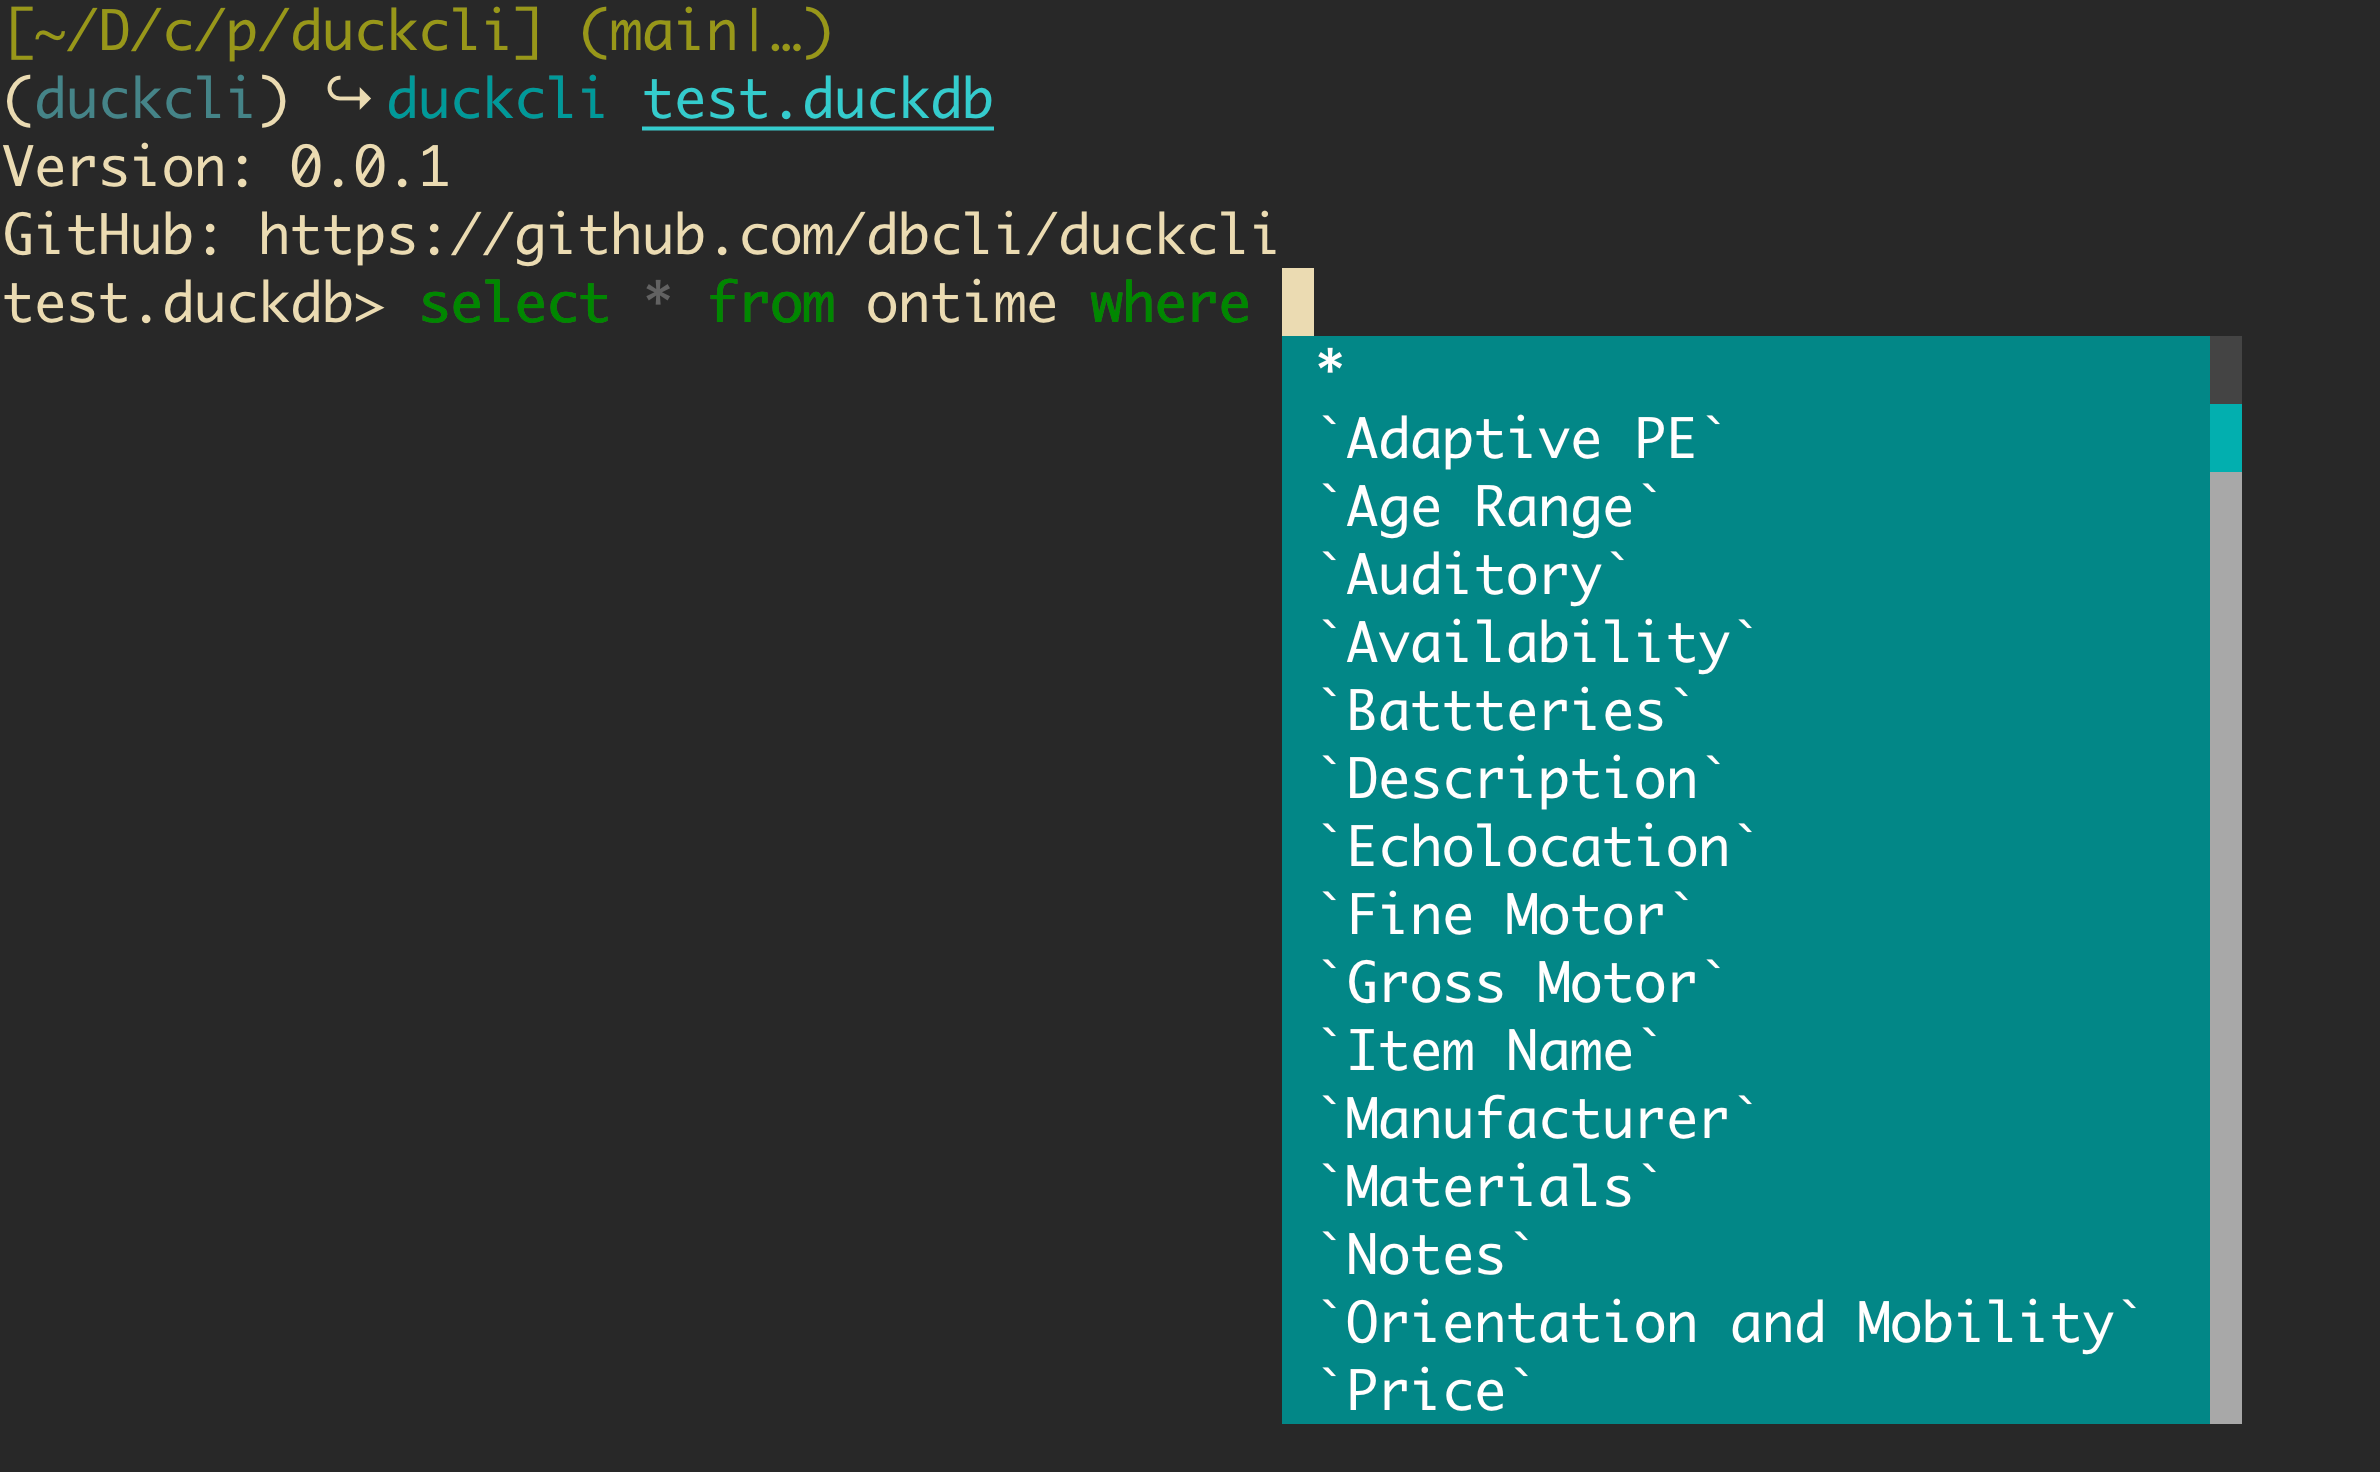
DuckDB CLI 自动补全和语法高亮


想补上 DuckDB 分析数据库指南?先看清你差在哪

说说你现在做什么、想去哪,按技能、证据、经验、表达、定位五类看差在哪、先补什么。不用登录。

对照我的情况

#真实使用场景

#场景一:本地大文件分析

公司给你一个 5GB 的用户行为日志 CSV,让你分析过去 30 天的活跃用户趋势。

用 Pandas 的痛苦:pd.read_csv() 先把 5GB 全部加载到内存,你的 16GB 笔记本直接卡死。就算用 chunksize 分块读取,代码写起来又臭又长。

用 DuckDB 的体验:

python
import duckdb result = duckdb.sql(""" SELECT DATE_TRUNC('day', event_time) as day, COUNT(DISTINCT user_id) as dau FROM 'user_events_202*.csv' WHERE event_time >= CURRENT_DATE - INTERVAL 30 DAY GROUP BY 1 ORDER BY 1 """).df() print(result)

几行代码,几秒出结果。DuckDB 在底下做了流式读取,不会一股脑把 5GB 全塞进内存。这种"看起来简单但底下做了很多事"的体验,是我喜欢 DuckDB 的主要原因。

#场景二:ETL 原型开发

这是我个人最高频的使用场景。写数据管道之前,总得在本地先跑通逻辑吧?以前要么连远程数据库(慢),要么本地装个 PostgreSQL(麻烦)。现在直接 DuckDB 搞定:

python
import duckdb con = duckdb.connect('prototype.duckdb') # 从不同格式的文件创建表 con.sql("CREATE TABLE orders AS SELECT * FROM 'orders.parquet'") con.sql("CREATE TABLE users AS SELECT * FROM 'users.csv'") con.sql("CREATE TABLE products AS SELECT * FROM 'products.json'") # 验证你的 ETL 逻辑 con.sql(""" CREATE TABLE order_summary AS SELECT u.country, p.category, DATE_TRUNC('month', o.created_at) as month, SUM(o.amount) as total_revenue, COUNT(DISTINCT o.user_id) as unique_buyers FROM orders o JOIN users u ON o.user_id = u.id JOIN products p ON o.product_id = p.id GROUP BY 1, 2, 3 """) # 验证没问题后,导出结果 con.sql("COPY order_summary TO 'output.parquet' (FORMAT PARQUET)")

跑通了就迁移到 BigQuery 或 Snowflake,SQL 几乎不用改。省掉的不只是时间,还有心智负担。

#场景三:Notebook 里的数据探索

在 Jupyter 里做探索性分析的时候,窗口函数、CTE 这些操作用 Pandas 写总是很别扭,用 SQL 就自然多了:

python
# 安装 JupySQL 扩展 # pip install jupysql duckdb-engine %load_ext sql %sql duckdb:// %%sql SELECT department, ROUND(AVG(salary), 2) as avg_salary, PERCENTILE_CONT(0.5) WITHIN GROUP (ORDER BY salary) as median_salary, COUNT(*) as headcount FROM 'employees.csv' GROUP BY department HAVING COUNT(*) > 5 ORDER BY avg_salary DESC

你试试用 Pandas 写一个 PERCENTILE_CONT,再对比 SQL 这几行,就知道为什么越来越多人在 Notebook 里混着用 SQL 了。


#DuckDB vs Pandas vs SQLite 详细对比

对比维度DuckDBPandasSQLite
定位嵌入式 OLAP 数据库数据操作库嵌入式 OLTP 数据库
查询语言SQL(兼容 PostgreSQL 语法)Python APISQL(语法较基础)
存储方式列式存储内存中的 DataFrame行式存储
大文件处理出色,流式读取不吃满内存全量加载,内存容易爆需要先导入,分析查询慢
多表 JOIN原生支持,优化器自动选执行计划merge() 写法不直观支持,但大表性能差
窗口函数完整支持有但写法复杂支持
并发写入单写多读不适用单写多读
适合数据量MB 到几十 GBMB 到几 GB(看内存)KB 到几 GB
学习成本会 SQL 就能上手需要学 Pandas API会 SQL 就能上手
生态集成Python, R, Node.js, Rust, JavaPython 为主几乎所有语言

简单来说:分析聚合选 DuckDB,数据清洗选 Pandas,应用存储选 SQLite。三者不是互斥的——我自己最常见的工作流是 DuckDB 做完聚合,.df() 转成 Pandas 再用 matplotlib 画图。各司其职,配合得很好。


#最容易翻车的地方

#1. DuckDB 不适合做应用数据库

这点我要特别强调,因为我见过有人踩这个坑。DuckDB 是 OLAP(分析),不是 OLTP(事务)。别拿它替代 SQLite 或 PostgreSQL 存用户数据、处理并发写入——它的写入是单线程的,高并发直接出问题。

#2. 内存还是有上限的

DuckDB 内存管理确实比 Pandas 好一大截,但不是无限的。100GB+ 的数据集还是会遇到瓶颈,这时候老老实实上 Spark 或 BigQuery。

#3. 持久化数据库文件的坑——我自己也中过招

python
# 内存模式(默认)——关掉就没了 con = duckdb.connect() # 持久化模式——数据存在文件里 con = duckdb.connect('my_data.duckdb')

我有一次花了大半个下午清洗数据、建好了几张中间表,结果忘了加文件路径,用的内存模式。关掉 Jupyter 的一瞬间人就傻了。从此之后养成习惯:只要不是写一次性脚本,第一行永远是 con = duckdb.connect('xxx.duckdb')。

#4. 版本兼容性

DuckDB 迭代很快,不同版本的持久化文件格式可能不兼容。升级版本后旧的 .duckdb 文件有可能打不开。所以重要数据务必同时导出一份 Parquet 备份,这个习惯能救命。

#5. 跨进程并发写入

多个 Python 进程同时写同一个 DuckDB 文件会直接报错。需要多进程写入的话,要么换 PostgreSQL,要么每个进程写自己的文件最后合并。这个限制不算 bug,是 DuckDB 作为嵌入式数据库的设计取舍。


#安装与快速上手

#安装

bash
# Python(最常用) pip install duckdb # Node.js npm install duckdb # 命令行工具(macOS) brew install duckdb # 命令行工具(Linux) # 从 GitHub Releases 下载:https://github.com/duckdb/duckdb/releases

#30 秒快速体验

python
import duckdb # 1. 直接查询 CSV print(duckdb.sql("SELECT * FROM 'data.csv' LIMIT 5")) # 2. 做聚合分析 print(duckdb.sql(""" SELECT category, SUM(revenue) as total FROM 'sales.csv' GROUP BY category ORDER BY total DESC """)) # 3. 和 Pandas 配合 import pandas as pd df = pd.DataFrame({'name': ['Alice', 'Bob', 'Charlie'], 'score': [85, 92, 78]}) result = duckdb.sql("SELECT * FROM df WHERE score > 80").df() print(result) # 4. 导出结果到 Parquet duckdb.sql("COPY (SELECT * FROM 'raw_data.csv' WHERE amount > 100) TO 'filtered.parquet' (FORMAT PARQUET)")

#命令行使用

bash
# 启动交互式 SQL 终端 duckdb # 直接对文件执行查询 duckdb -c "SELECT COUNT(*) FROM 'logs.csv'" # 打开已有的数据库文件 duckdb my_data.duckdb

#进阶技巧

#用 DuckDB 替代 pd.read_csv()

当 CSV 文件较大时,用 DuckDB 读取比 Pandas 快得多:

python
import duckdb # 比 pd.read_csv() 快 5-10 倍 df = duckdb.sql("SELECT * FROM 'large_file.csv'").df()

#查询远程 S3 文件

python
import duckdb con = duckdb.connect() con.sql("INSTALL httpfs; LOAD httpfs;") con.sql("SET s3_region = 'ap-southeast-2';") result = con.sql("SELECT * FROM 's3://my-bucket/data/*.parquet' LIMIT 100")

#多文件批量查询

sql
-- 查询目录下所有 CSV SELECT * FROM 'data/2024/*.csv'; -- 带文件名列,知道每行来自哪个文件 SELECT filename, * FROM glob('data/2024/*.csv');

#相关资源

  • Pandas 指南 — 数据清洗和逐行操作的首选工具
  • Polars 指南 — 另一个高性能 DataFrame 库,和 DuckDB 互补
  • Jupyter 指南 — 在 Notebook 中使用 DuckDB 的最佳搭档
  • DuckDB 官网:https://duckdb.org↗
  • DuckDB 文档:https://duckdb.org/docs/↗
  • DuckDB GitHub:https://github.com/duckdb/duckdb↗
发布团队
JR Academy
学习资料

个人作者与审校人按实际记录署名。

免费资源

精选免费资料与工具合集

课程、工具与资料一站式获取。

查看免费资源 →

相关指南

Pandas 数据分析指南Pandas 数据分析指南→
Polars 高性能数据分析指南Polars 高性能数据分析指南→
Jupyter Notebook 指南Jupyter Notebook 指南→

相关路线图

ai-engineer→

常见问题

DuckDB 和 SQLite 有什么区别?
SQLite 是 OLTP 数据库,适合事务处理;DuckDB 是 OLAP 数据库,专为分析查询优化,列式存储速度更快。
DuckDB 可以替代 Pandas 吗?
在 SQL 友好的分析场景下可以。DuckDB 可以直接用 SQL 查询 CSV/Parquet 文件,且大数据集性能远超 Pandas。

看完了,下一步

想补上 DuckDB 分析数据库指南?先看清你差在哪

说说你现在做什么、想去哪,按技能、证据、经验、表达、定位五类看差在哪、先补什么。不用登录。

对照我的情况
  • 定位按岗位看学习路线图前端、后端、数据、AI 等方向,按阶段列出要学的内容和先后顺序。看全部路线图 →
  • 技能常用命令和语法速查Git、Linux、Python、SQL 等常用写法整理在一页,写代码时随手查。看 Cheat Sheets →
  • 技能按方向免费学 AIVibe Coding、AI 办公、Prompt、AI Engineer 等方向,按章节从入门学起。看全部学习方向 →

目录

  • DuckDB 指南
  • 先说结论:DuckDB 适合谁
  • DuckDB 的核心能力
  • 1. 直接用 SQL 查询文件——这个功能真的会上瘾
  • 2. 和 Python 无缝集成
  • 直接查询 Pandas DataFrame,不需要导入
  • 查询结果直接转回 DataFrame
  • 也可以转成 Polars DataFrame
  • 或者直接转成 Python 列表
  • 3. 列式存储:为什么分析场景下它碾压 SQLite
  • 4. 向量化执行
  • 真实使用场景
  • 场景一:本地大文件分析
  • 场景二:ETL 原型开发
  • 从不同格式的文件创建表
  • 验证你的 ETL 逻辑
  • 验证没问题后,导出结果
  • 场景三:Notebook 里的数据探索
  • 安装 JupySQL 扩展
  • pip install jupysql duckdb-engine
  • DuckDB vs Pandas vs SQLite 详细对比
  • 最容易翻车的地方
  • 1. DuckDB 不适合做应用数据库
  • 2. 内存还是有上限的
  • 3. 持久化数据库文件的坑——我自己也中过招
  • 内存模式(默认)——关掉就没了
  • 持久化模式——数据存在文件里
  • 4. 版本兼容性
  • 5. 跨进程并发写入
  • 安装与快速上手
  • 安装
  • Python(最常用)
  • Node.js
  • 命令行工具(macOS)
  • 命令行工具(Linux)
  • 从 GitHub Releases 下载:https://github.com/duckdb/duckdb/releases
  • 30 秒快速体验
  • 1. 直接查询 CSV
  • 2. 做聚合分析
  • 3. 和 Pandas 配合
  • 4. 导出结果到 Parquet
  • 命令行使用
  • 启动交互式 SQL 终端
  • 直接对文件执行查询
  • 打开已有的数据库文件
  • 进阶技巧
  • 用 DuckDB 替代 `pd.read_csv()`
  • 比 pd.read_csv() 快 5-10 倍
  • 查询远程 S3 文件
  • 多文件批量查询
  • 相关资源

这项技能你需要补吗?

带上这页的主题,对照你的情况看差在哪。

对照我的情况